이종 GPU 클러스터 LLM 추론 최적화 가이드
이종 GPU 클러스터 LLM 추론 — 이종 GPU 클러스터를 활용한 LLM 추론 최적화 방법을 알아봅시다. Blackwell GPU 프리필과 고메모리 노드 디코드 분리, RDMA 기반 KV Cache 전달 메커니즘을 상세 분석합니다.
 tt
이종 GPU 클러스터 LLM 추론 — 이종 GPU 클러스터를 활용한 LLM 추론 최적화 방법을 알아봅시다. Blackwell GPU 프리필과 고메모리 노드 디코드 분리, RDMA 기반 KV Cache 전달 메커니즘을 상세 분석합니다.
로컬 LLM 배포를 위한 완벽 가이드. VRAM 티어별 최적 모델(GLAM-5.1, Qwen3.5, Gemma4)과 1-bit 양자화 기술을 소개합니다. 데이터 보안이 중요한 한국 IT 환경에 맞춘 실무 패턴을 확인하세요.
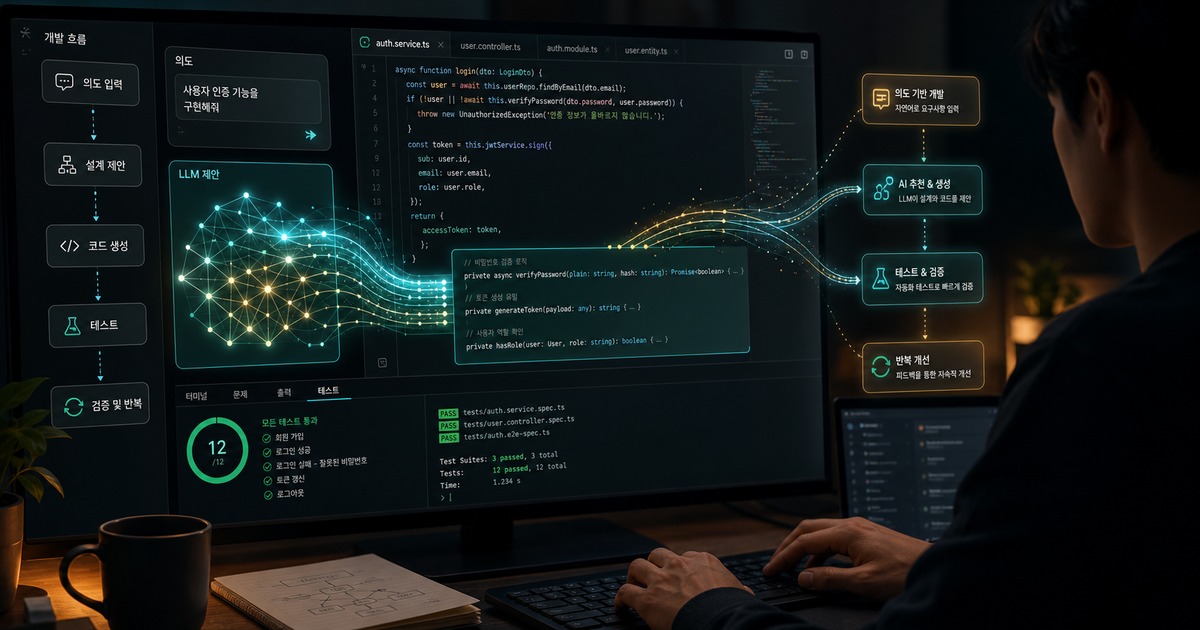
LLM 바이브코딩은 생성형 AI로 의도와 맥락 기반 코드를 생성하는 고차원 개발 패러다임입니다. 작게 시작하여 반복하는 실무 전략과 테스트 주도 접근법을 알아보세요.
연속적 사고 추론(Chain of Continuous Thought)은 LLM이 언어 대신 잠재 공간에서 직접 사고하는 혁신적 패러다임입니다. 토큰 90% 감소와 추론 정확도 향상을 달성한 Coconut의 핵심 메커니즘을 지금 확인하세요.
AI 모델 비교 플랫폼 Countless.dev는 LLM, TTS, STT를 단일 인터페이스에서 비교할 수 있습니다. 한국 스타트업이 겪는 비용·성능·한국어 성능 문제를 해결하는 방법을 알아보세요.
LLaMA.cpp MTP 추론 속도 — LLaMA.cpp MTP(Multi-Token Prediction)로 Gemma 4 26B 추론 속도를 97에서 138 tokens/s로 40% 향상시키는 방법. Speculative Decoding 원리와 한국 개발 환경 적용 가이드.
허깅페이스 악성코드가 Open-OSS/privacy-filter 모델로 위장해 유포 중입니다. Python 드로퍼가 Windows Task Scheduler를 악용하는 다단계 공격 구조를 상세히 분석하고, MLOps 파이프라인 보호를 위한 즉각적인 점검 방안을 확인하세요.

Claude Code, OpenAI Codex CLI, Gemini CLI의 핵심 기능을 심층 비교합니다. 프로젝트 컨텍스트 관리, 샌드박스 보안, MCP 연동 등을 통해 2026년 개발 워크플로우에 최적인 AI CLI 도구를 찾아보세요.

OpenAI Codex CLI로 터미널에서 AI 코딩 자동화를 구현하는 실전 가이드. 설치부터 승인 모드, Skills 활용, CI 파이프라인 통합까지.
Synology NAS AI 자동화 서버를 Docker Compose + ofelia로 구축하는 방법. GPU 없이 월 1만 원 미만으로 24시간 AI 파이프라인을 운영하는 실전 가이드.