Jev 모델 구조화 출력 아키텍처 해부 가이드
Jev 모델 구조화 출력 아키텍처를 해부합니다. 분류 로짓 기반 단일 포워드 패스로 70-500ms 내 JSON Schema 준수와 보정된 신뢰도를 반환하는 의사결정 전용 모델의 핵심 구조를 분석합니다.
AI 모델, 머신러닝, 딥러닝
Jev 모델 구조화 출력 아키텍처를 해부합니다. 분류 로짓 기반 단일 포워드 패스로 70-500ms 내 JSON Schema 준수와 보정된 신뢰도를 반환하는 의사결정 전용 모델의 핵심 구조를 분석합니다.

LLM 프로덕션 배포 시 양자화·병렬화·추론 최적화를 조합하면 처리량이 3~5배 달라집니다. vLLM·AWQ·텐서 병렬화 실전 설정과 A100 기준 벤치마크를 정리했습니다.

ChatGPT GPT 5.6는 모델 성능보다 chat·work·codex·site 4축 작업 공간 구조가 핵심입니다. 모드별 용도와 할당량 변화, 실무 활용법을 정리했습니다.
로컬 LLM 1조 파라미터 실행 — 로컬 LLM 1조 파라미터 모델을 768GB Optane PMem + 12GB GPU로 실행하는 방법. MoE 아키텍처 활용, llama.cpp 설정, 메모리 계층화 전략을 단계별로 설명합니다.
로컬 LLM 32GB VRAM 비교 — 로컬 LLM 32GB VRAM 환경에서 Qwen3 35B A3B, Qwen3 27B, Gemma 4 26B, Nemotron 3 Nano 4개 모델을 코드 이해 태스크로 비교 분석. 장문맥 처리 아키텍처와 실제 성능 평가.
DeepSeek V4 Pro 로컬 추론을 단일 워크스테이션에서 성공적으로 수행한 사례를 분석합니다. llama.cpp CUDA 빌드와 Q4_K_M 양자화로 89.4GB VRAM에서 구동하는 설치 방법과 성능 벤치마크를 확인하세요.
Star Elastic 추론 제어는 NVIDIA가 공개한 단일 체크포인트 기반 스펙트럼 추론 기술입니다. Gumbel-Softmax 라우터로 30B, 23B, 12B 모델을 제로샷 슬라이싱하여 사고·답변 단계별 동적 용량 할당을 구현하는 방법을 알아보세요.
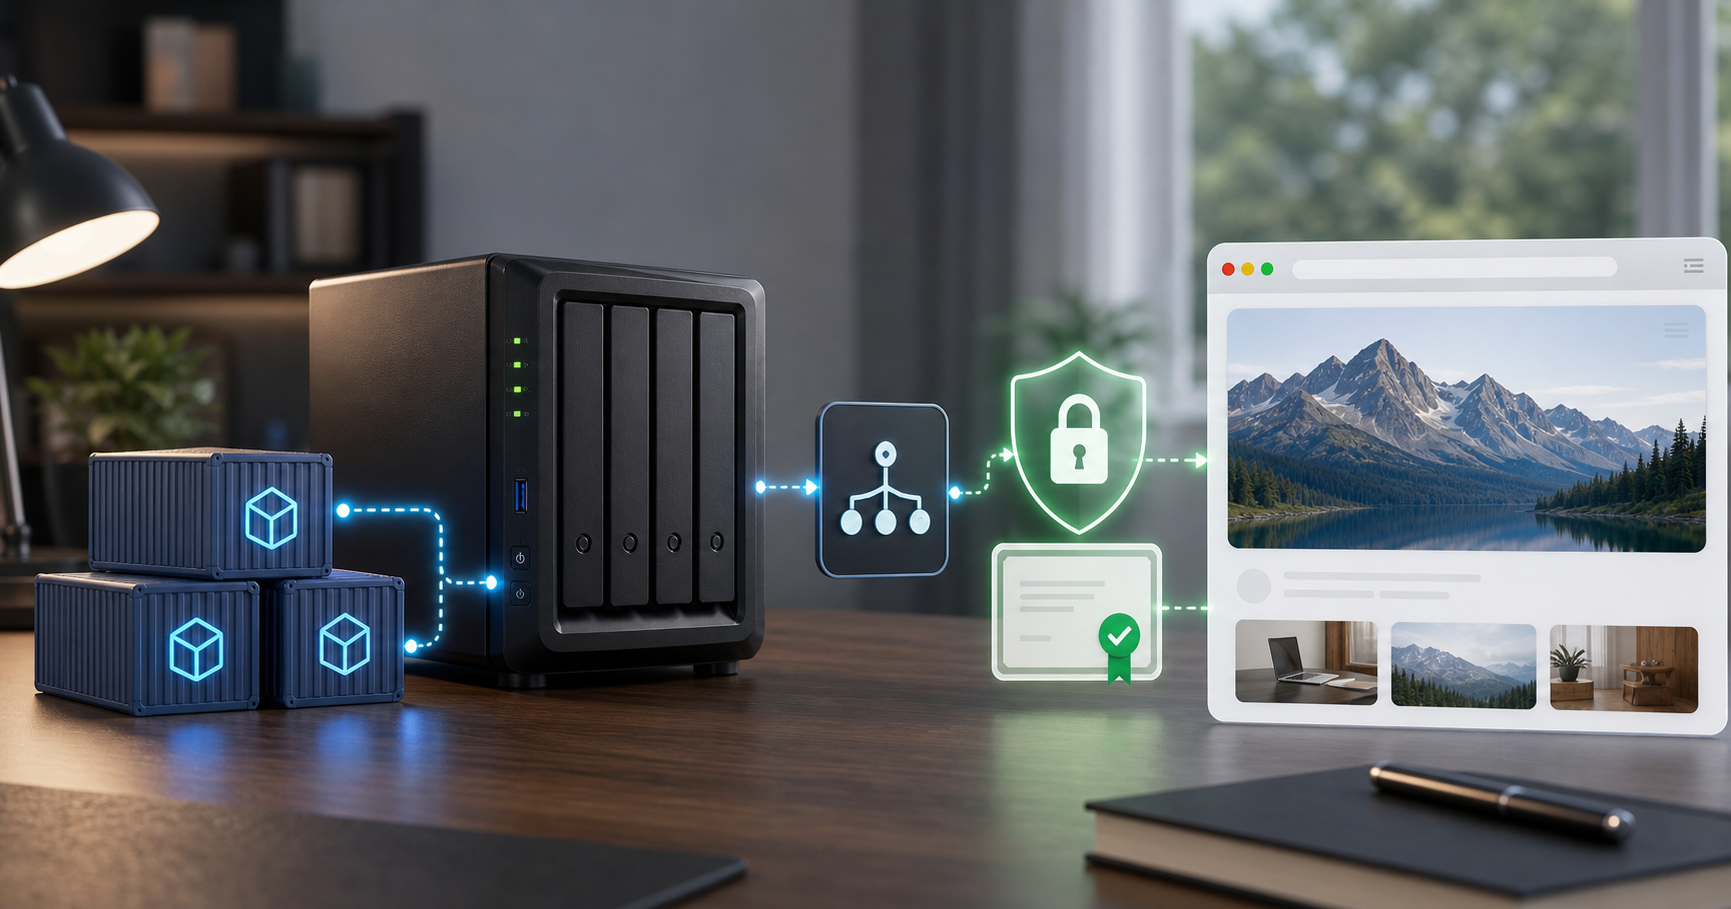
Synology DSM 7.2에서 Docker Compose로 WordPress, MariaDB, Nginx Proxy Manager 스택을 구성하고 Let’s Encrypt HTTPS를 적용하는 완전 자립 운영 체크리스트.
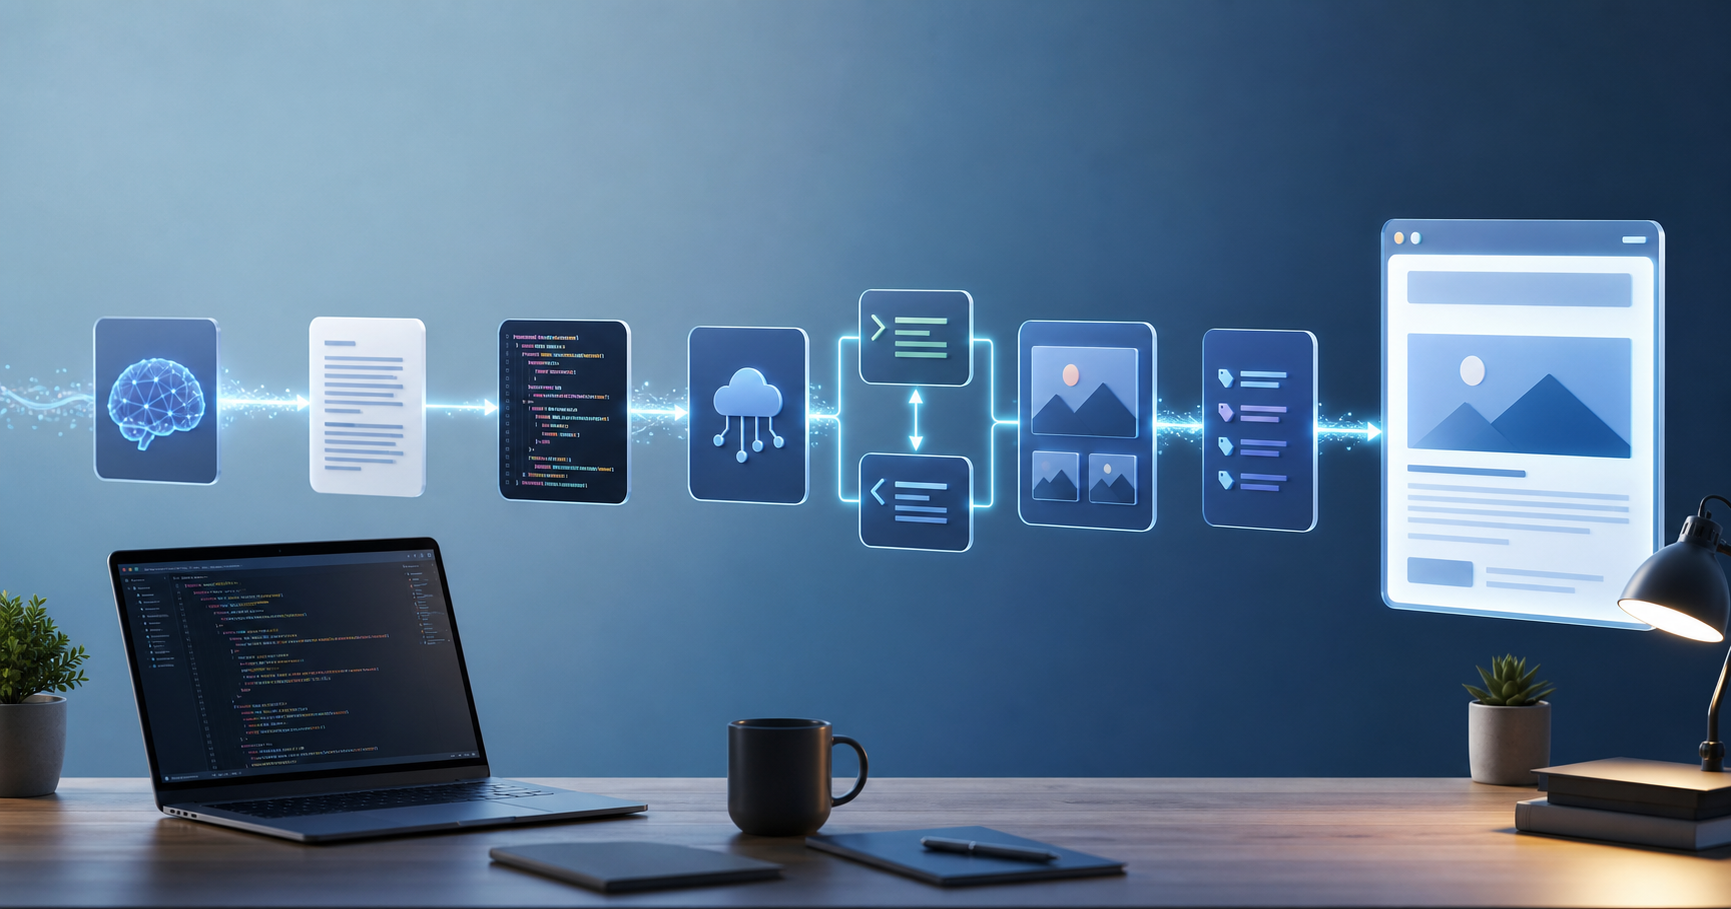
WordPress REST API와 Python으로 LLM 기반 블로그 자동 발행 파이프라인을 구축하는 방법. Application Password 인증, 미디어 업로드, Rank Math SEO 메타 설정까지 실전 가이드.